Je komt vaak op een website waarvan je alle rubrieken wilt bekijken, maar waarvan de navigatie slechts een deel van de inhoud laat zien. De sitemap is het bestand met de URL’s die een website beschikbaar stelt. Als je weet waar je die kunt vinden en hoe je hem leest, krijg je toegang tot pagina’s die niet via het menu of de interne zoekfunctie onder de aandacht worden gebracht.
Het XML-sitemapbestand van een website openen
De eenvoudigste methode is om het adres van de website, gevolgd door /sitemap.xml, in de adresbalk van je browser in te voeren. Op de meeste websites die zijn gebouwd met een CMS zoals WordPress, Shopify of Joomla, leidt deze URL naar een XML-bestand met een overzicht van de gepubliceerde pagina’s.
Geeft dit adres een 404-fout, probeer dan een paar varianten: /sitemap_index.xml, /sitemap1.xml of /sitemap/. De bestandsnaam is niet gestandaardiseerd; elk CMS of elke plugin hanteert zijn eigen conventie.
Een andere betrouwbare manier is het robots.txt-bestand van de website openen (via /robots.txt). Dit bestand bevat vaak een regel met “Sitemap:” die de exacte locatie van de sitemap aangeeft. Dit is overigens de methode die Google aanbeveelt sinds het in 2023 het oude systeem voor meldingen via ping heeft afgeschaft. Bekijk bijvoorbeeld de sitemap van Double Portion om te zien hoe een goed gestructureerde sitemap op een echte website eruitziet.
Sitemap-index en onderliggende bestanden: een omvangrijke sitemap lezen
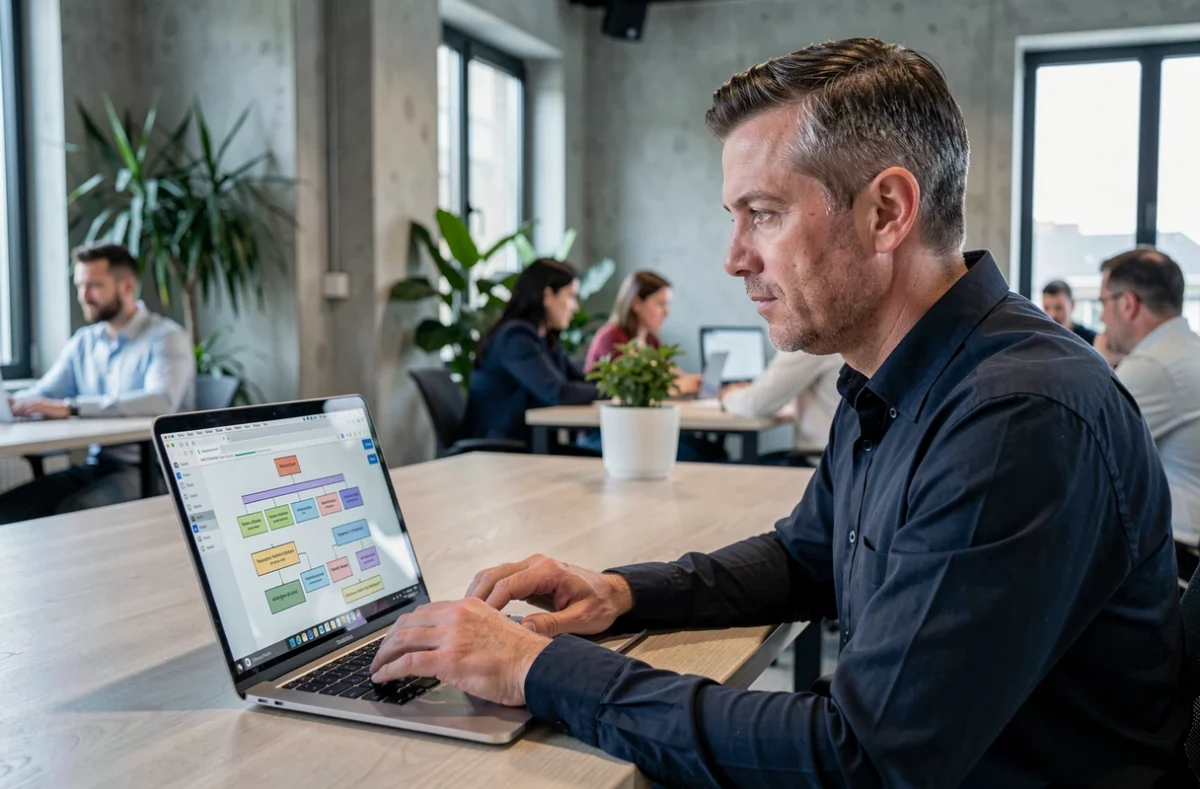
Op grote websites bevat het eerste bestand dat je tegenkomt niet de volledige lijst met URL’s. Het is een sitemap-index: een bestand dat verwijst naar meerdere onderliggende sitemaps. Elk onderliggend bestand bevat een reeks URL’s, vaak ingedeeld naar type inhoud (artikelen, producten, categorieën).
Google hanteert een limiet per bestand: maximaal 50.000 URL’s en maximaal 50 MB ongecomprimeerd. Daarboven moet de website de sitemap opsplitsen in meerdere bestanden die via deze index aan elkaar zijn gekoppeld. Wil je echt alle pagina’s bekijken, dan moet je dus elk onderliggend bestand openen en niet alleen het eerste niveau bekijken.
In de praktijk klik je in de browser op elke link in de sitemap-index. Het XML-bestand wordt weergegeven met de tags loc (de URL van de pagina) en soms lastmod (de datum van de laatste wijziging). Op een e-commercewebsite met duizenden productpagina’s is elk bestand afzonderlijk bekijken de enige manier om een volledig overzicht te krijgen.
Is de lastmod-tag betrouwbaar om updates te herkennen?
Google geeft aan dat deze datum alleen wordt meegenomen als die echte inhoudelijke wijzigingen weerspiegelt. Veel CMS’en werken de datum bij telkens wanneer het bestand opnieuw wordt gegenereerd, ook als de pagina zelf niet is gewijzigd. Een recente lastmod-datum garandeert niet dat de inhoud is aangepast. Je kunt er dus niet op vertrouwen om bijgewerkte pagina’s te herkennen zonder ze handmatig te controleren.
Drie situaties waarin de sitemap niet alles laat zien
De sitemap is een declaratief overzicht. Er staan alleen pagina’s in die de generator erin opneemt. Verschillende situaties kunnen ervoor zorgen dat de werkelijke inhoud van de website niet overeenkomt met wat de sitemap laat zien.
- Weespagina’s (zonder interne links) ontbreken vaak in de sitemap, vooral wanneer die automatisch wordt gegenereerd op basis van de navigatiestructuur van de website
- Pagina’s die door een regel in robots.txt of een noindex-tag worden uitgesloten, kunnen uit het bestand verdwijnen, ook als ze technisch gezien nog steeds rechtstreeks via hun URL toegankelijk zijn
- Dynamisch gegenereerde inhoud (filterresultaten, interne zoekpagina’s) staat bijna nooit in een sitemap, omdat dit duizenden dubbele URL’s zou opleveren
Om deze hiaten op te vullen, kun je de sitemap aanvullen met een crawl van de website via een tool zoals Screaming Frog of Xenu. Deze programma’s volgen alle interne links en brengen pagina’s aan het licht die de sitemap overslaat.
Google Search Console en robots.txt gebruiken om gegevens te vergelijken
Als je je eigen website beheert, geeft Google Search Console een overzicht van de geïndexeerde pagina’s en meldt het welke pagina’s problemen opleveren. In het onderdeel “Sitemaps” kun je het bestand indienen en controleren hoeveel URL’s zijn ontdekt en hoeveel daarvan daadwerkelijk zijn geïndexeerd.
Het verschil tussen die twee aantallen zegt veel. Een sitemap kan honderden pagina’s bevatten, terwijl Google er maar een fractie van indexeert. De oorzaken lopen uiteen: te weinig inhoud, dubbele pagina’s, omleidingsfouten of simpelweg een ontoereikend crawlbudget voor een grote website.
Sitemap en robots.txt vergelijken om inconsistenties op te sporen
Het robots.txt-bestand kan de toegang tot volledige mappen blokkeren, terwijl de URL’s daarvan wel in de sitemap staan. Door dit conflict kunnen zoekmachines deze pagina’s niet verwerken. Door de twee bestanden op elkaar af te stemmen, kun je zulke tegenstrijdigheden oplossen.
Open hiervoor robots.txt, zoek de regels met “Disallow” en vergelijk die met de URL’s in de sitemap. Staat een URL in beide bestanden, dan is er iets mis en moet je dit corrigeren: verwijder de pagina uit de sitemap of haal de blokkeerregel weg.
Een sitemap lezen zonder technische kennis
Het XML-formaat dat onbewerkt in de browser wordt weergegeven, kan nogal onoverzichtelijk zijn. Sommige browsers, zoals Chrome, tonen de tags zonder opmaak, waardoor het lastig is om een bestand met duizenden regels te lezen.
Met een paar eenvoudige oplossingen wordt dat een stuk makkelijker:
- Kopieer de URL van de sitemap naar een online XML-viewer, die de gegevens overzichtelijk weergeeft in een tabel met sorteerbare kolommen
- Gebruik een browserextensie voor XML-bestanden, die de inhoud automatisch van kleuren en inspringingen voorziet
- Open het bestand in een spreadsheetprogramma door de XML te importeren. Zo kun je de URL’s filteren en sorteren op datum of websiteonderdeel
De sitemap is het snelste startpunt om een website in kaart te brengen, zolang je die niet verwart met een volledig overzicht. Door dit bestand te vergelijken met robots.txt, een technische crawl of Search Console krijg je een veel betrouwbaarder beeld van wat een website daadwerkelijk bevat.